Opphavsrett under kunstig intelligens (COPY.AI)
- Avdeling Statistisk modellering og maskinlæring
- Involverte fagområder Språkteknologi
COPY.AI undersøker hvordan innholdsskapere kan få anerkjennelse og kompensasjon når arbeidet deres brukes til å trene generativ KI, samtidig som det legges til rette for ansvarlig utvikling av nye KI-modeller.
En utfordring for skapere og KI-utviklere
Generative KI-systemer som ChatGPT trenes på store mengder innhold fra nettet, blant annet opphavsrettsbeskyttede bøker, artikler, fotografier og illustrasjoner. Imidlertid får skaperne ofte ikke informasjon om hvorvidt eller hvordan arbeidet deres er brukt, og blir sjelden kreditert eller kompensert.
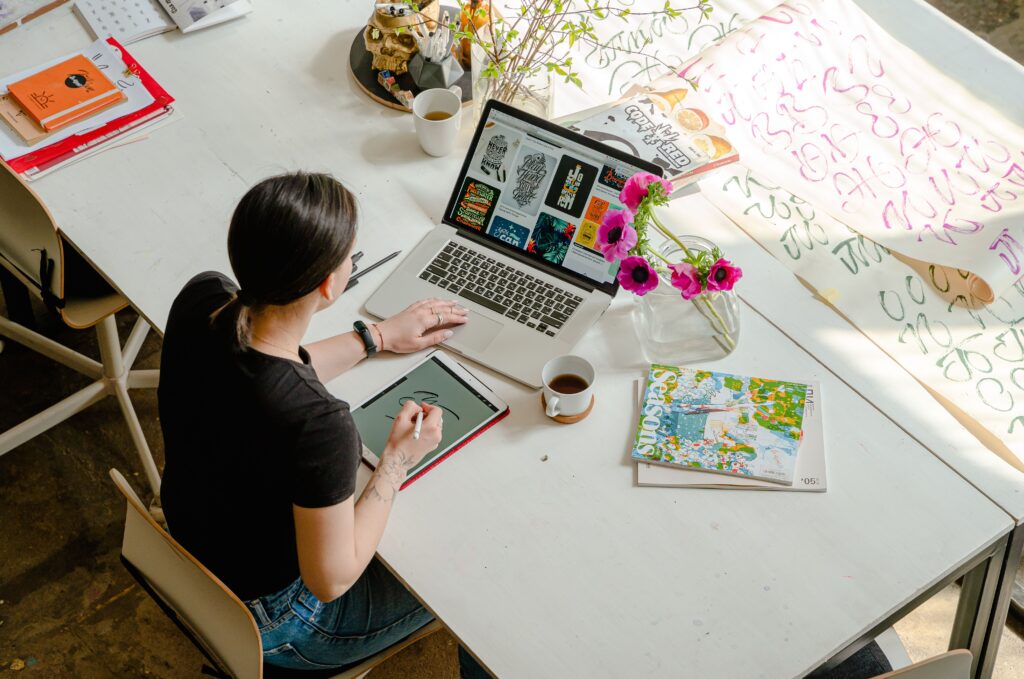
Tenk deg en illustratør som deler porteføljen sin på nettet. Bildene kan bli inkludert i et datasett som brukes til å trene en generativ KI-modell, uten av illustratøren vet om det. Når modellen først er trent, kan det være vanskelig å fastslå om akkurat disse illustrasjonene ble brukt, hvordan de påvirket resultatene, og om og hvordan illustratøren bør anerkjennes eller betales for bruken.
Derfor begrenser stadig flere skapere tilgangen til verkene sine eller reserverer seg mot at de skal brukes til KI-trening. Dette kan gi dem større kontroll, men kan også få flere utilsiktede konsekvenser. Dersom arbeidet blir mindre tilgjengelig, kan det bli vanskeligere for skaperne å nå ut til publikum, bli oppdaget av potensielle oppdragsgivere og tjene penger. KI-utviklere kan på sin side få problemer med å skaffe pålitelige, varierte og representative treningsdata. Det kan svekke kvaliteten på modellene og resultatene de gir.
Hva skal COPY.AI undersøke?
Hvordan kan vi beskytte opphavsretten og samtidig gi utviklere tilgang til dataene de trenger for å utvikle generativ KI på en ansvarlig måte?
COPY.AI samler forskere innen språkteknologi, maskinsyn, maskinlæring, immaterialrett, teknologi og økonomi. Med særlig vekt på den nordiske og baltiske kulturarven skal prosjektet utforske juridiske, tekniske og økonomiske løsninger som ivaretar både skapernes rettigheter og behovet for KI-utvikling.
Forskerne skal undersøke:
- Hvordan opphavsrettslige regler bør anvendes når beskyttet materiale brukes til å trene KI-modeller uten tillatelse fra skaperne.
- Hvordan vi kan finne ut om bestemte opphavsrettsbeskyttede verk er brukt til å trene en modell, og om resultatene kan spores slik at skapernes bidrag kan identifiseres.
- Når KI-generert innhold kan krenke opphavsretten.
- Hvordan generative systemer kan utformes for å redusere risikoen for overtredelser.
- Hvordan innholdsskapere kan få betalt for bidragene sine, og hvilke ordninger som er juridisk, økonomisk og teknisk gjennomførbare.
Måten vi løser disse utfordringene på, vil være viktig for den digitale kulturen vi deler. Når menneskeskapt innhold verdsettes og brukes på rettferdige vilkår, kan det gi KI-systemer et bedre grunnlag for videre utvikling og redusere risikoen for at nettet fylles av ensforming innhold av lav kvalitet.
Relaterte områder
Vil du vite mer om COPY.AI?
Ta kontakt.
Prosjekt: COPY.AI: Preserving Intellectual Property and Cultural Diversity in the Age of Generative AI.
Partnere: Københavns universitet, Danmarks tekniske universitet, Lunds universitet, Universitetet i Tartu
Finansiering: Nordforsk
Periode: 2026-2028
Aktuelle lenker
COPY.AI (prosjektets nettside, engelsk)
Ideen om en innholdsavgift for KI breer seg (13. mai 2026)
COPY.AI i Nasjonalt vitenarkiv
COPY.AI hos Nordforsk (engelsk)
COPY.AI er en del av TRUST: Norsk senter for pålitelig kunstig intelligens
